概念
树链剖分 就是对一棵树分成几条链,把树形变为线性,减少处理难度
轻重链剖分
前置芝士:
- 重儿子:对于每一个非叶子节点,它的儿子中儿子数量最多的那一个儿子为该节点的重儿子
- 轻儿子:对于每一个非叶子节点,它的儿子中非重儿子的剩下所有儿子即为轻儿子
- 重边:连接任意两个重儿子的边叫做重边
- 轻边:剩下的即为轻边
- 重链:相邻重边连起来的连接一条重儿子的链叫重链
可参照 oi-wiki 的图感性理解
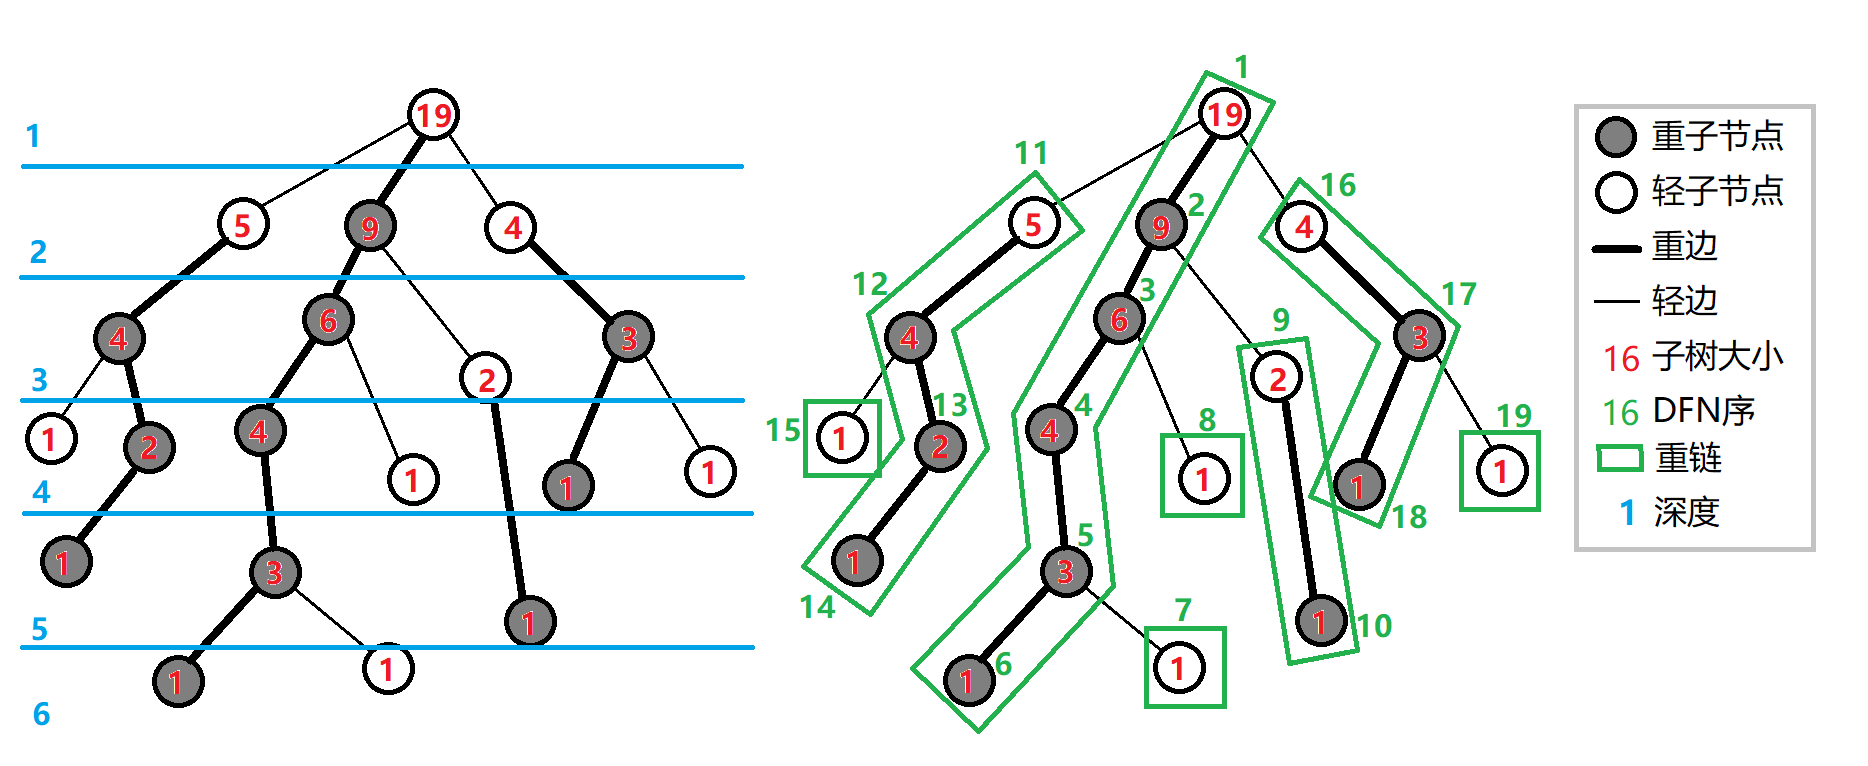
我们想一想怎么剖分这个树
这里给出一种两次深搜的方法
变量定义:
- wt[]:初始点权数组
- son[]:重儿子编号
- id[]:新编号
- fa[]:父亲节点
- dep[]:深度
- siz[]:子树大小
- top[]:当前链顶端节点
- cnt:dfs序
dfs1
第一次深搜,我们需要:
- 标记出每个点的深度 \(dep\)
- 标记出每个点的父亲 \(fa\)
- 标记出每个非叶子节点的子树大小(含它自己)
- 标记出每个非叶子节点的重儿子编号 \(son\)
代码实现还是比较简单的:
void dfs1(int u, int f, int deep) {
    dep[u] = deep; // 标记深度
    fa[u] = f; // 标记父亲
    siz[u] = 1; // 标记子树大小
    int maxson = -1; // 记录重儿子的儿子数

    for (int i = 0, v; i < edge[u].size(); ++i) {
        v = edge[u][i];

        if (v == f)
            continue;

        dfs1(v, u, deep + 1);
        siz[u] += siz[v];

        if (siz[v] > maxson) {
            son[u] = v;
            maxson = siz[v]; // 标记每个非叶子节点的重儿子编号
        }
    }
}
dfs2
第二次深搜,我们需要:
- 标记每个点的新编号id[]
- 赋值每个点的初始值到新编号上
- 处理每个点所在链的顶端top[]
诶等等,这个新编号是什么玩意儿?
简单地说,就是给这个节点打上一个新的下标,之后有妙用。
一定要按照先处理重儿子再处理轻儿子的顺序,这样之后对整棵树的维护会很方便。
为什么呢?
我们模拟一下,按照这种顺序,每一条重链的新编号是连续的
因为是dfs,所以每一个子树的新编号也是连续的
可能到这里还是看不出来方便在哪,咱们先上代码
inline void dfs2(int u, int topf) { // topf当前链的最顶端的节点
    id[u] = ++cnt; // 标记每个点的新编号
    wt[cnt] = w[u]; // 把每个点的初始值赋到新编号上来
    top[u] = topf; // 标记这个点所在链的顶端

    if (!son[u])
        return ;

    dfs2(son[u], topf); // 按先处理重儿子后处理轻儿子的顺序

    for (int i = 0, v; i < edge[u].size(); ++i) {
        v = edge[u][i];

        if (v == fa[u] || v == son[u])
            continue;

        dfs2(v, v); // 对于每一个轻儿子都有一条从它自己开始的链
    }
}
与路径有关的操作
当我们要求任意两点间路径上的点权和时,设所在链顶端的深度更深的那个点为u
- 把答案加上 u 点到 u 所在链顶端 这一段区间的点权和
- 把 u 跳到 u 所在链顶端的那个点的上面一个点
不停执行这两个步骤,直到两个点处于一条链上,这时再加上此时两个点的区间和即可
这时我们注意到,我们所要处理的所有区间均为连续编号(新编号)
于是可以用线段树处理
修改任意两点间路径上的点权也是这个道理
代码:
inline void UpdateChain(int u, int v, int val) { // 修改任意两点间路径上的点权
    val %= Mod;

    while (top[u] != top[v]) { // 当两个点不在同一条链上
        if (dep[top[u]] < dep[top[v]]) // 把 u 点改为所在链顶端的深度更深的那个点
            swap(u, v);

        tree.update(1, id[top[u]], id[u], val); // 修改 u 点到 u 所在链顶端这一段区间的点权和
        u = fa[top[u]]; // 把 u 跳到 u 所在链顶端的那个点的上面一个点
    }// 直到两个点处于一条链上为止

    if (dep[u] > dep[v])
        swap(u, v); // 把u点变为深度更浅的那个点

    tree.update(1, id[u], id[v], val); // 直接修改即可
}

inline int QueryChain(int u, int v) { // 求任意两点间路径上的点权和
    int res = 0; // 原理与上一个函数类似,这里不再阐述

    while (top[u] != top[v]) {
        if (dep[top[u]] < dep[top[v]])
            swap(u, v);

        res = (res + tree.query(1, id[top[u]], id[u])) % Mod;
        u = fa[top[u]];
    }

    if (dep[u] > dep[v])
        swap(u, v);

    res = (res + tree.query(1, id[u], id[v])) % Mod;
    return res;
}
与子树有关的操作
我们在深搜时记录了每个非叶子节点的子树大小(含它自己),并且每个子树的新编号都是连续的
直接线段树区间查询即可
简短的代码:
inline void UpdateSubtree(int u, int val) { // 修改一点及其子树的点权和
    tree.update(1, id[u], id[u] + siz[u] - 1, val); // 子树区间左端点为id[u],右端点为id[x]+siz[x]-1
}

inline int QuerySubtree(int u) { // 求一点及其子树的点权和
    return tree.query(1, id[u], id[u] + siz[u] - 1); // 原理与上一个函数类似,这里不再阐述
}
应用
#include <cstdio>
#include <vector>
using namespace std;
const int N = 1e5 + 7;

vector<int> edge[N];

int w[N], wt[N];

int son[N], id[N], fa[N], dep[N], siz[N], top[N];

int n, m, r, Mod;
int cnt;

template<int SIZE>
struct SegmentTree {
    struct SMT {
        int l, r, siz;
        int sum, tag;
    } s[SIZE << 2];
    inline int ls(int u) {
        return u << 1;
    }
    inline int rs(int u) {
        return u << 1 | 1;
    }
    inline void pushup(int u) {
        s[u].sum = (s[ls(u)].sum + s[rs(u)].sum) % Mod;
    }
    inline void pushdown(int u) {
        s[ls(u)].tag = (s[ls(u)].tag + s[u].tag) % Mod;
        s[rs(u)].tag = (s[rs(u)].tag + s[u].tag) % Mod;
        s[ls(u)].sum = (s[ls(u)].sum + s[u].tag * s[ls(u)].siz) % Mod;
        s[rs(u)].sum = (s[rs(u)].sum + s[u].tag * s[rs(u)].siz) % Mod;
        s[u].tag = 0;
    }
    inline void build(int u, int l, int r) {
        s[u].l = l, s[u].r = r, s[u].siz = r - l + 1;

        if (l == r) {
            s[u].sum = wt[l] % Mod;
            return ;
        }

        int mid = (l + r) >> 1;
        build(ls(u), l, mid);
        build(rs(u), mid + 1, r);
        pushup(u);
    }
    inline void update(int u, int l, int r, int val) {
        if (l <= s[u].l && s[u].r <= r) {
            s[u].tag = (s[u].tag + val) % Mod;
            s[u].sum = (s[u].sum + s[u].siz * val) % Mod;
            return ;
        }

        if (s[u].tag)
            pushdown(u);

        int mid = (s[u].l + s[u].r) >> 1;

        if (l <= mid)
            update(ls(u), l, r, val);

        if (r > mid)
            update(rs(u), l, r, val);

        pushup(u);
    }
    inline int query(int u, int l, int r) {
        if (l <= s[u].l && s[u].r <= r)
            return s[u].sum;

        if (s[u].tag)
            pushdown(u);

        int mid = (s[u].l + s[u].r) >> 1, res = 0;

        if (l <= mid)
            res = (res + query(ls(u), l, r)) % Mod;

        if (r > mid)
            res = (res + query(rs(u), l, r)) % Mod;

        return res;
    }
};

SegmentTree<N> tree; // 线段树

inline void AddEdge(int u, int v) {
    edge[u].push_back(v);
}

inline void dfs1(int u, int f, int deep) {
    dep[u] = deep; // 标记深度
    fa[u] = f; // 标记父亲
    siz[u] = 1; // 标记子树大小
    int maxson = -1; // 记录重儿子的儿子数

    for (int i = 0, v; i < edge[u].size(); ++i) {
        v = edge[u][i];

        if (v == f)
            continue;

        dfs1(v, u, deep + 1);
        siz[u] += siz[v];

        if (siz[v] > maxson) {
            son[u] = v;
            maxson = siz[v]; // 标记每个非叶子节点的重儿子编号
        }
    }
}

inline void dfs2(int u, int topf) { // topf当前链的最顶端的节点
    id[u] = ++cnt; // 标记每个点的新编号
    wt[cnt] = w[u]; // 把每个点的初始值赋到新编号上来
    top[u] = topf; // 标记这个点所在链的顶端

    if (!son[u])
        return ;

    dfs2(son[u], topf); // 按先处理重儿子后处理轻儿子的顺序

    for (int i = 0, v; i < edge[u].size(); ++i) {
        v = edge[u][i];

        if (v == fa[u] || v == son[u])
            continue;

        dfs2(v, v); // 对于每一个轻儿子都有一条从它自己开始的链
    }
}

inline void UpdateChain(int u, int v, int val) {
    val %= Mod;

    while (top[u] != top[v]) { // 当两个点不在同一条链上
        if (dep[top[u]] < dep[top[v]]) // 把 u 点改为所在链顶端的深度更深的那个点
            swap(u, v);

        tree.update(1, id[top[u]], id[u], val); // 修改 u 点到 u 所在链顶端这一段区间的点权和
        u = fa[top[u]]; // 把 u 跳到 u 所在链顶端的那个点的上面一个点
    }// 直到两个点处于一条链上为止

    if (dep[u] > dep[v])
        swap(u, v); // 把u点变为深度更浅的那个点

    tree.update(1, id[u], id[v], val); // 直接修改即可
}

inline int QueryChain(int u, int v) { // 原理与上一个函数类似,这里不再阐述
    int res = 0;

    while (top[u] != top[v]) {
        if (dep[top[u]] < dep[top[v]])
            swap(u, v);

        res = (res + tree.query(1, id[top[u]], id[u])) % Mod;
        u = fa[top[u]];
    }

    if (dep[u] > dep[v])
        swap(u, v);

    res = (res + tree.query(1, id[u], id[v])) % Mod;
    return res;
}

inline void UpdateSubtree(int u, int val) {
    tree.update(1, id[u], id[u] + siz[u] - 1, val); // 子树区间左端点为id[u],右端点为id[x]+siz[x]-1
}

inline int QuerySubtree(int u) { // 原理与上一个函数类似,这里不再阐述
    return tree.query(1, id[u], id[u] + siz[u] - 1);
}

signed main() {
    scanf("%d%d%d%d", &n, &m, &r, &Mod);

    for (int i = 1; i <= n; ++i)
        scanf("%d", w + i);

    for (int i = 1, u, v; i < n; ++i) {
        scanf("%d%d", &u, &v);
        AddEdge(u, v), AddEdge(v, u);
    }

    dfs1(r, 0, 1), dfs2(r, r); // 两次深搜
    tree.build(1, 1, n); // 建树

    for (int op, u, v, val; m; --m) {
        scanf("%d", &op);

        if (op == 1) {
            scanf("%d%d%d", &u, &v, &val);
            UpdateChain(u, v, val);
        } else if (op == 2) {
            scanf("%d%d", &u, &v);
            printf("%d\n", QueryChain(u, v));
        } else if (op == 3) {
            scanf("%d%d", &u, &val);
            UpdateSubtree(u, val);
        } else  {
            scanf("%d", &u);
            printf("%d\n", QuerySubtree(u));
        }
    }

    return 0;
}