网络流(Flow)
目录也炸了
网络流概念
定义
对于任意一张有向图(网络)\(G = (V, E)\), 每条边\((u, v)\in{E}\)都有一个权值\(c(u, v)\), 称之为容量, 当\((u, v)\notin{E}\)时有\(c(u, v) = 0\)。其中有源点 $S\in{V}\ $和汇点 \(T\in{V}\ , (S\not= T)\) 。
流
设\(f(u, v)\) 定义为\(u, v\) 的流量, f为网络的流函数, 它满足三个条件
- \(f(u, v)\le\ c(u,v)\)
- \(f(u, v) = -f(v, u)\)
- \(\forall{x}\not=S, x\not=T,f(u, v) = \Sigma_{(v, u)\in{E}}f(v, u)\)
三大性质:
- 每条边的流量不能大于这条边的容量.
- 正向边的流量=反向边的流量
- 正向的流量和=反向的所有流量和
残量网络
在任意时刻,网络中所有节点以及剩余容量(剩余流量=\(c(u,v) -f(u,v)\))大于0的边构成的子图被称为残量网络
最大流
我们有一张图,要求从源点流向汇点的最大流量(可以有很多条路到达汇点),就是我们的最大流问题。
这个定义有点抽象,上图来讲
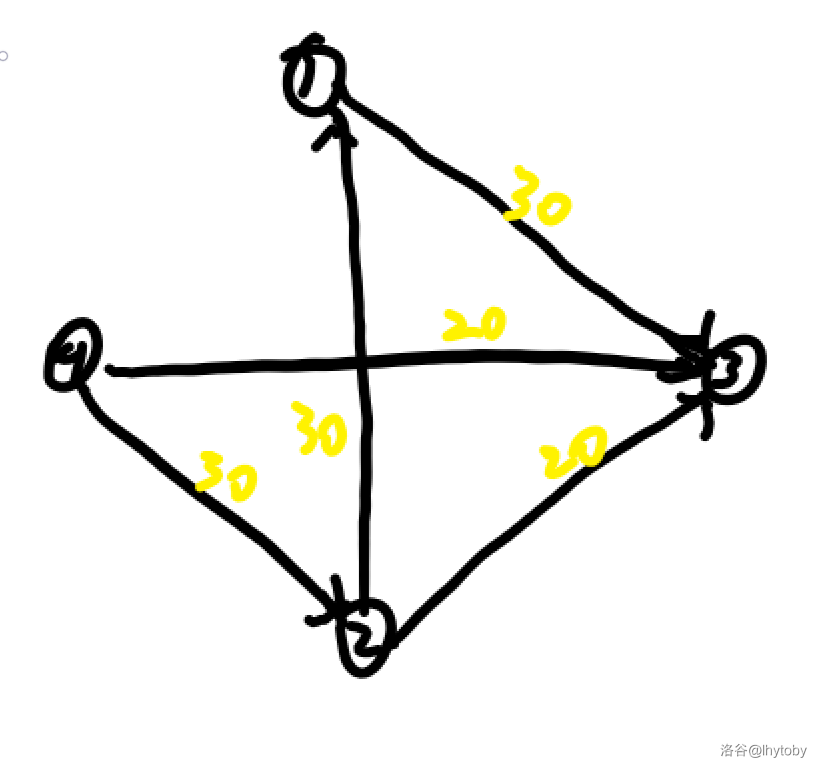
假设有这样一张图,黄色的数字是这条边的容量。一开始我们从源点(4)放流,让流通过可以到达汇点(3)的边。由于1性质.
每条边的流量不能大于这条边的容量.
所以我们下的流量不能超过这条路径的最小容量。
照片无了, 这个故事告诉我们在机房写一定不要保存到c盘,警钟长鸣!!!!!!!!!!又补上了
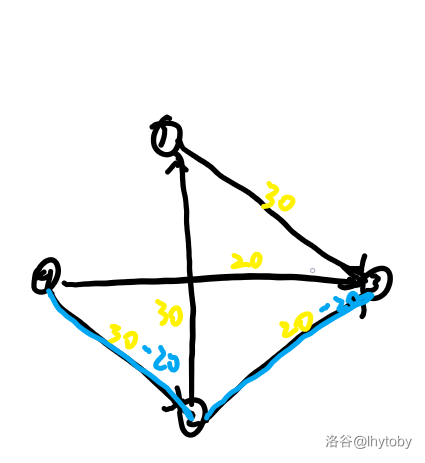
一条路径从源点到汇点,4->2->3, 因为这条路径最小容量是20 ,所以下20流量,流量在经过4->2后只剩20,这条边剩余流量-20,再经过2->3,只剩20,这条边剩余流量-20,到了汇点只剩20。
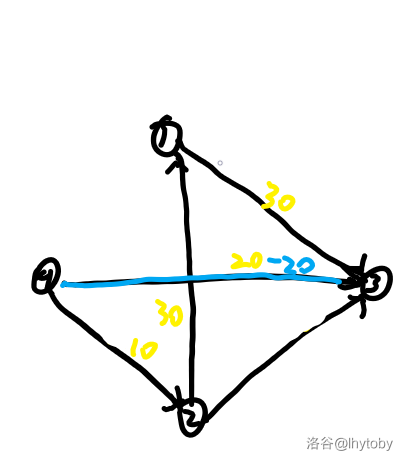
一条路径从源点到汇点,4->3, 因为这条路径最小容量是20 ,所以下20流量,流量在经过4->2后只剩20,这条边剩余流量-20,到了汇点只剩20。
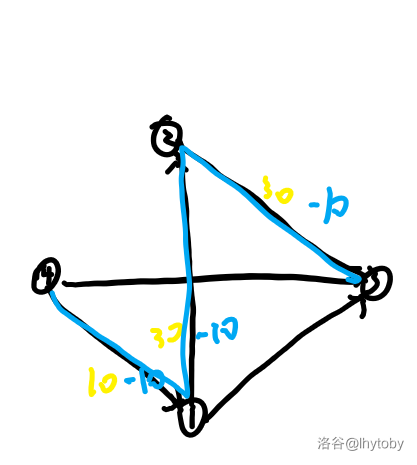
一条路径从源点到汇点,4->2->1->3, 因为这条路径最小容量是10 ,所以下10流量, 流量经过4->2只剩10,这条边剩余流量-10,在经过2->1只剩10,这条边剩余流量-10,在经过1->3只剩10,这条剩余流量-10,到了汇点只剩10.
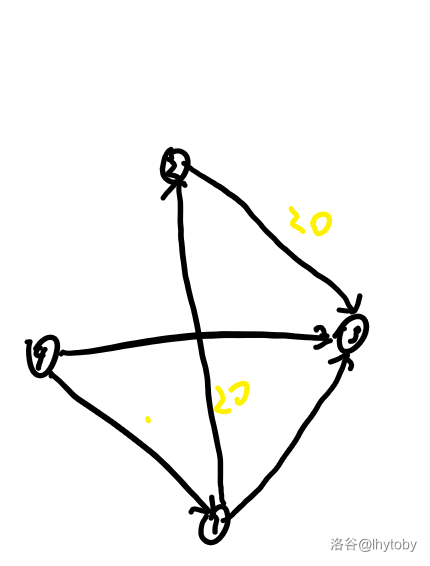
最后是这样的,流到汇点的流量之和是20+20+10=50,所以最大流是50。
EK增广路(Edmonds−Karp)
增广路(Augmenting Path)
若一条从S到T的路径上的所有边的剩余容量都大于0, 这条路径就是一条增广路
核心思想
如上图模拟,显然我们可以让一股流沿着增广路从S流到T,然后使网络的流量增大
EK算法的思想就是不断用BFS寻找增广路(因为我们流量经过的能到汇点的路径他下放的流量是以这条边的最小容量而定,如果不是那么就无法经过,所以这条路径一定得是增广路。)并不断更新最大流量值,直到网络上不存在增广路为止
实现过程
用BFS找增广路只考虑剩余流量不为0的边, 找一条从S到T的路径,计算出路径上各边剩余容量值的最小值dis(原因如上图模拟下发时解释), 则网络的最大流量就可以增加dis(在模拟过程中我们可以发现最后到汇点的流量就是下发的流量)。
反向边
为什么要建反向边?
因为可能一条边可以被包含于多条增广路径,所以为了寻找所有的增广路经我们就要让这一条边有多次被选择的机会
而构建反向边则是这样一个机会,相当于给程序一个反悔的机会!
为什么是反悔?
因为我们在找到一个dis后,就会对每条边的容量进行减法操作(容量要减去经过的流量),而直接更改值就会影响到之后寻找另外的增广路。
原本A到B的正边权是1、反边权是0,在第一次经过该边后(假设dis值为1),则正边权变为0,反边权变为1
当我们需要第二次经过该边时,我们就能够通过走反向边恢复这条边的原样
算法竞赛进阶指南这样讲:
当一条边的流量\(f(u, v) > 0\)时,根据斜对称性质(第二条性质),他的反向边流量\(f(u, v) <0\),此时必定有\(f(v, u)<c(v, u)\),所以EK算法除了遍历原图的正向边以外还要考虑每条反向边
如何存储反向边,如何调用?
我们邻接表存储时idx从2开始,正向会是2, 4, 6...., 反向3, 5, 7....,我们可以发现,对于每一个正向的的编号xor上1,那么就会成为反向边,每一组是2 ^ 1 = 3, 4 ^ 1 = 5这样找反向,反向5 ^ 1 = 4, 3 ^ 1 = 2,同理。
时间复杂度
这个就很玄学了,有时我们可以过\(10^5\)的网络题,有时不能,但是一般这个可以处理\(10^3 到10^4\)规模的网络,时间复杂度为\(O(nm^2)\)。
Dinic算法
EK算法每次有可能会遍历整个残量网络,但只找出一条增广路
而Dinic算法可以一次找多条增广路
分层图
使用bfs,我们知道对于一个节点\(u\), \(d[u]\)表示它的层次,及\(S\)到\(u\)经过的边数,假设\((u, v)\in{E}\) ,那么\(d[v] = d[u] + 1\)。在残量网络中,满足\(d[v]=d[u] +1\)的边构成的子图被称为分层图。
DFS
在DFS中,从S开始,每次我们向下一层次随便找一个点,直到到达T,然后再一层一层回溯回去,继续找这一层的另外的点再往下搜索
这样就满足了我们同时求出多条增广路的需求!
算法流程
1.在残量网络上BFS求出点的层次,构造分层图。
2.在分层图上DFS寻找增广路,并进行剪枝,剪掉增广完后的点,回溯改边权
当前弧优化
对于节点\(u\), 在DFS走到第\(i\)条弧时, 前\(i - 1\)条弧到汇点的流一定已经被流满而没有可行的路线了
那么当下一次再访问\(x\)节点时,前\(i-1\)条弧就没有意义了
所以我们可以在每次枚举节点\(x\)所连的弧时,改变枚举的起点,这样就可以删除起点以前的所有弧,来达到优化剪枝的效果
对应到代码中,就是now数组, 先初始化,一开始BFS它先是对应每个点的h数组,在DFS当前点的now数组等于他指向的点的编号,因为前面都是大于0的,所以就可以剪掉,直接从指向的点开始。
使用当前弧优化和不使用对比
变化明显(下方加了当前弧优化)
时间复杂度
时间复杂度:\(O(n^2m)\),一般能够处理\(10^4到10^5\)规模的网络
相较于EK算法,显然Dinic算法的效率更优也更快:虽然在稀疏图中区别不明显,但在稠密图中Dinic的优势便凸显出来了(所以Dinic算法用的更多)
ISAP算法(Improved Shortest Augumenting Path)
ISAP比Dinic更快。这两个对比起来Dinic需要跑许多遍BFS,导致算法效率不高。
ISAP只用跑一遍BFS。
算法流程
1.从汇点到源点跑BFS(注意不是源点到汇点)
2.从源点到汇点跑DFS,直到出现断层。
ISAP 只跑一遍 bfs 标记深度,然后每个点都会随着一次次 dfs 而变高。
GAP优化
此时我们引进GAP优化, \(gap\)数组,\(gap[i]\)表示高度为\(i\)的点的个数。当\(gap[i]=0\)就出现了断层,\(s\)和\(t\)不再联通,我们就停止寻找。
当前弧优化
跟Dinic算法一样。
HLPP算法
解决最大流问题,最常用的算法是Dinic和ISAP,两种算法在实际应用中都相当快速。但是就理论而言,两种算法都属于增广路算法,复杂度上界都达到了\(O(n^2m)\),因此在某些题目中或许存在毒瘤出题人构造数据卡这两种算法的情况。因此本文讲解一种复杂度上界在常用最大流算法中最优的最高标号预留推进算法(又叫HLPP),其上界为\(O(n^2\sqrt{m})\),并且在经过优化后这种算法在数据随机的情况下速度也不亚于上述两种增广路算法。
主要思想
以水流来类比网络流。我们将每个点看作一个水库,每条边看作单向的管道。预流推进算法的思想就是,允许水在非源汇点的节点中暂时存储(我们将存储在非源汇点中的流称作这个点的超额流),同时伺机将自身的超额流通过管道推送出去。只要保证在算法结束后所有非源汇点的超额流都为0,那么这种方案就是合法的。
同时为了避免反复推送而出现死循环的问题,我们再给每个节点引入高度的概念。同实际中一样,我们只允许高度较高的节点向高度较低的节点进行推送(不过还是略有不同,具体请见下文)。如果一个节点因为受到高度的限制而不能推送自身的超额流,那么我们就抬高这个节点的高度,我们把这个操作叫做重贴标签。
实现过程
我们用\(d_u\)表示\(u\)的高度,\(c_u\)表示\(u\)的超额流。
首先,我们将除了源点以外的节点的高度都置为0。我们将源点s的高度置为n,并且将s的所有边都充满流量推送出去。我们不必担心这种操作会让流变得太多,因为多余的流量会在别的节点高度抬高到超过s以后推送回去。我们还应该将推送过后超额流不为0的节点加入队列中等待推送,同时,因为HLPP会要求我们每次都推送高度最高的节点(注意是对于超额流不为0的节点而言的),因此这应当是一个以高度为键值的优先队列。
我们每一次取出队首\(u\)尝试推送,遍历所有\(u\)的出边,设做\(v\),如果\(v\)流量并且满足正好比\(u\)的高度多1,就可以操作,推送的流量不能超过这条边的容量,也不可以超过\(c_u\),修改\(u,v\)的超额流,若\(v\)未加入过优先队列,则将\(v\)加入优先队列。
如果发现超额流不为0,说明高度不够,所以要重贴标签。我们先找到还有容量的边,且\(d_v+1<d_u\) ,就将\(d_u=d_v+1\),再重新把\(u\)加入优先队列。
如果优先队列为空,那么除了源汇点以外的所有节点超额流都为0,这是一个合法的流,并且也是最大流。
浅浅优化一下
将所有点的初始高度设为到\(t\)的最短距离,但\(d_s\)的高度还是\(n\)。
使用GAP优化,在重贴标签以后,如果GAP数组不为0,说明当前高度还有点,如果没有,说明高于他的点不能将流量送到汇点,那么就我们可以将高度大于\(d_u\)且小于\(n+1\)的点高度设为\(n+1\)。
算法速度对比(可能有的数据范围太小体现不出来)